IA open source ou propriétaire ? Market overview
L'IA open source est passée d'une niche technique à un sujet de conseil d'administration.
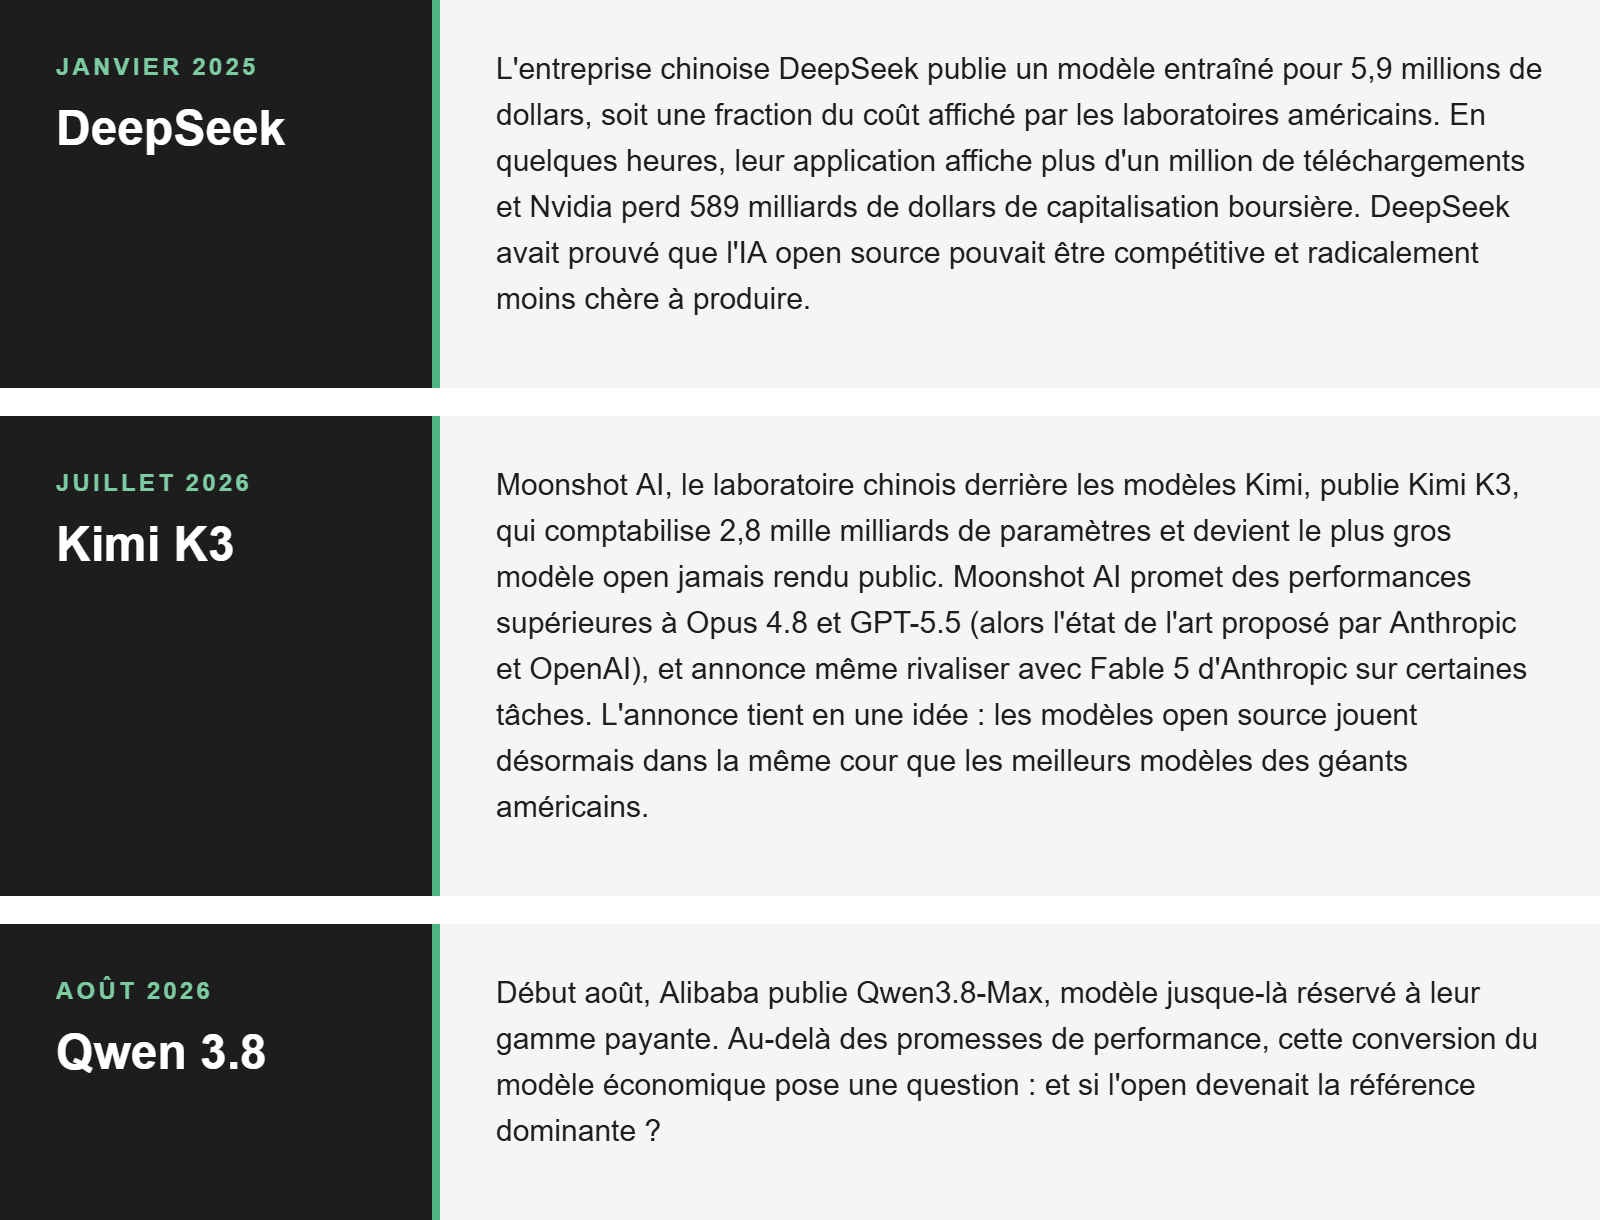
Ces trois épisodes ont installé un narratif simple et souvent relayé dans la presse et les réseaux sociaux : l'open source aurait définitivement rattrapé l'IA propriétaire sur la performance, et la Chine mène la course seule.
01 - Open source, open-weight : de quoi parle-t-on vraiment ?
Avant d'aller plus loin, une clarification s'impose. Les modèles cités précédemment ne sont pas « open source » au sens strict du terme, mais « open-weight ». C'est-à-dire que seuls les paramètres entraînés sont publics ; les données, le code et la méthodologie d'entraînement restent propriétaires. Sans accès à ces données, il n'est pas possible de déterminer si les performances sur les benchmarks viennent des capacités réelles du modèle, ou bien si l'entreprise a volontairement « contaminé » l'apprentissage de son modèle avec les questions du benchmark elles-mêmes.
Le mot « open » en IA recouvre aussi un spectre de régimes juridiques large. Si certains laboratoires publient sous licence Apache 2.0 (pleinement permissive), leurs meilleurs modèles, comme Qwen3.8-Max chez Alibaba, sont souvent soumis à des licences sur-mesure imposant un partage de revenus au-delà d'un seuil d'usage commercial.
02 - Open contre propriétaire : l'écart est-il vraiment refermé ?
Une fois ces clarifications posées, reste la question : l'open source a-t-il rattrapé son retard sur le propriétaire ?
Plusieurs sites spécialisés dans le suivi des benchmarks rapportent un écart quasi nul. Les sources académiques indépendantes ne vont pas dans ce sens : l'AI Index 2026 de Stanford mesure un écart entre meilleur modèle fermé et meilleur modèle ouvert passé de 0,5 % en août 2024 à 3,3 % en mars 2026. Epoch AI chiffre ce retard à quatre à six mois de décalage capacitaire. Kimi K3 et Qwen3.8-Max ont été annoncés en tête des classements avant leur sortie par leurs propres laboratoires, ils se retrouvent respectivement troisième et quatrième après les évaluations indépendantes.
Un écart qui dépend de la tâche
En outre, la différence de performance réelle dépend de la tâche évaluée. Sur les tâches de pointe (raisonnement mathématique, programmation), les modèles fermés jouissent de volumes de données propriétaires plus importants, ce qui leur permet aussi d'être plus performants sur les langues autres que l'anglais. Ils sont aussi généralement développés avec plus de garde-fous qui leur offrent une meilleure stabilité une fois en production.
Chine, États-Unis, Europe : qui domine l'open ?
Reste le deuxième présupposé : la Chine dominerait complètement l'open.
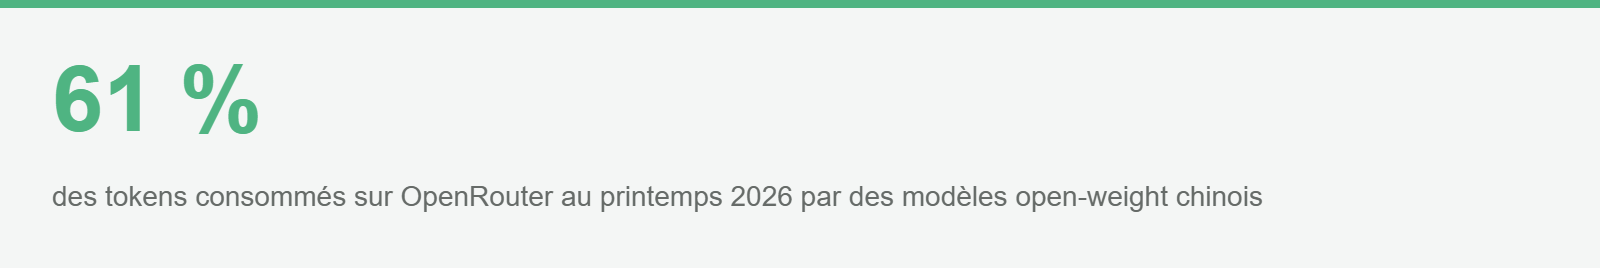
Au printemps 2026, les modèles open-weight chinois représentaient environ 61 % des tokens consommés sur OpenRouter, et Llama, le pionnier américain, avait disparu du classement des modèles les plus utilisés.
Mais la véritable bataille des modèles ouverts, ça n'est pas celle des benchmarks ni du clash entre deux superpuissances : c'est celle des coûts.
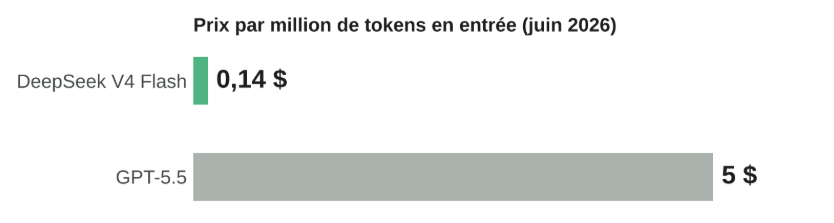
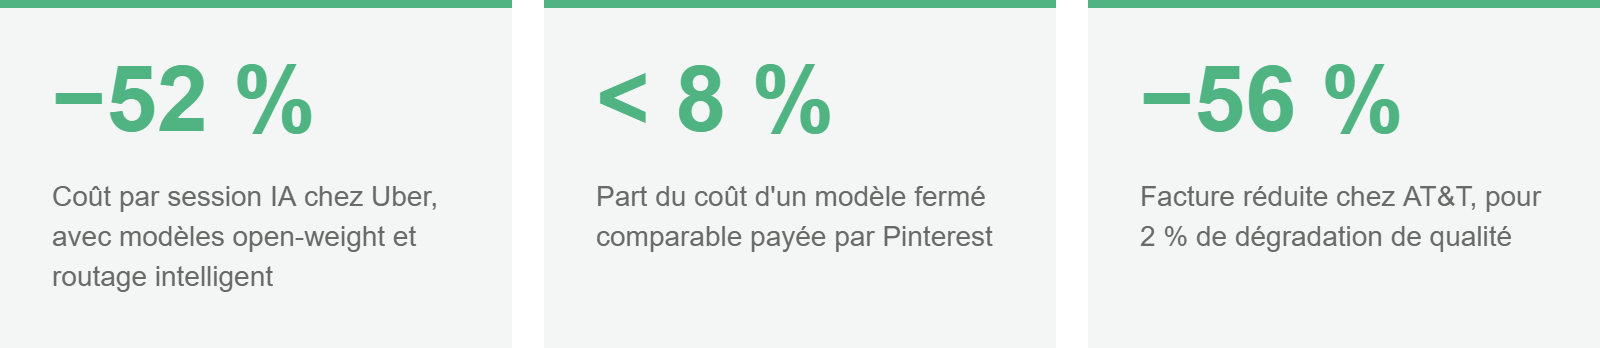
En juin 2026, DeepSeek V4 Flash était facturé 0,14 $ par million de tokens en entrée, contre 5 $ pour GPT-5.5. Uber a réduit son coût par session IA de 52 % en combinant modèles open-weight et routage intelligent des requêtes. Pinterest paie moins de 8 % du coût d'un modèle fermé comparable en post-entraînant des modèles open sur ses données propriétaires. AT&T a coupé 56 % de sa facture en substituant l'open source à Claude sur les tâches n'exigeant pas un raisonnement de pointe, pour 2 % seulement de dégradation de qualité mesurée.
Ces entreprises n'ont pas complètement remplacé les modèles propriétaires par des modèles ouverts : elles ont ajouté une couche de routage entre l'application et les modèles, grâce à laquelle chaque requête est classée selon sa complexité et sa sensibilité, puis envoyée vers le modèle le moins cher capable de la traiter.
Les modèles ouverts amènent donc à des économies réelles et mesurées en production ; mais ces modèles, où tournent-ils et sous la responsabilité de qui ?
Dans l'immense majorité des cas, les entreprises ne déploient pas les modèles sur leur propre infrastructure. Elles passent par des fournisseurs d'inférence tiers (Together, Fireworks, Groq), qui hébergent les poids ouverts et les facturent à l'usage, comme le ferait une API propriétaire comme celle d'Anthropic ou d'OpenAI. La licence du modèle change, mais le mode de consommation reste donc identique.
SOUVERAINETÉ
Pour finir, la question du contrôle et de l’accès aux données ne dépend pas de la licence ; c’est le lieu et mode de déploiement du modèle qui dictent qui a accès à quoi. Mistral, par exemple, déploie ses propres modèles directement sur l’infrastructure de clients du secteur de la défense, quand la plupart des modèles ouverts (chinois ou américains) passent par une API tierce. La souveraineté dépend donc du choix combiné du type de licence et du lieu de déploiement ; utiliser Mistral via un fournisseur d’inférence américain n’est pas plus souverain qu’utiliser un modèle chinois via un fournisseur qui héberge en UE
03 - Ce qu'il faut retenir
Le déploiement en local est souvent présenté comme la voie vers la souveraineté. Mais il reste aujourd'hui — encore — l'exception plutôt que la norme. Selon Forrester, aucune entreprise commerciale européenne majeure ne se passera totalement des hyperscalers américains en 2026. Gartner projette de son côté que 75 % des entreprises auront une stratégie de souveraineté numérique d'ici 2030 (contre 5 % en 2025). Le mix entre hyperscalers, acteurs souverains et auto-hébergement est à composer.
Le questionnement doit donc aller bien au-delà du modèle « open ou fermé » : une bonne évaluation doit comprendre le coût total de la stack technique et le risque fournisseur (qui héberge les données ? qui peut y accéder ? comment éviter le lock-in ? qui porte la responsabilité ? pour quelles données / quels usages ?). Comment trouver une solution qui convienne vraiment à votre entreprise, en prenant en compte toutes ces dimensions ? Nous y répondrons dans notre prochain article… stay tuned !
Open, propriétaire, hybride : quelle architecture pour votre entreprise ?
Coût réel, contrôle des données, réversibilité, responsabilité, dépendance : eleven accompagne les dirigeants sur leur stratégie IA. Échangeons sur votre situation avec Morand Studer, Partner eleven